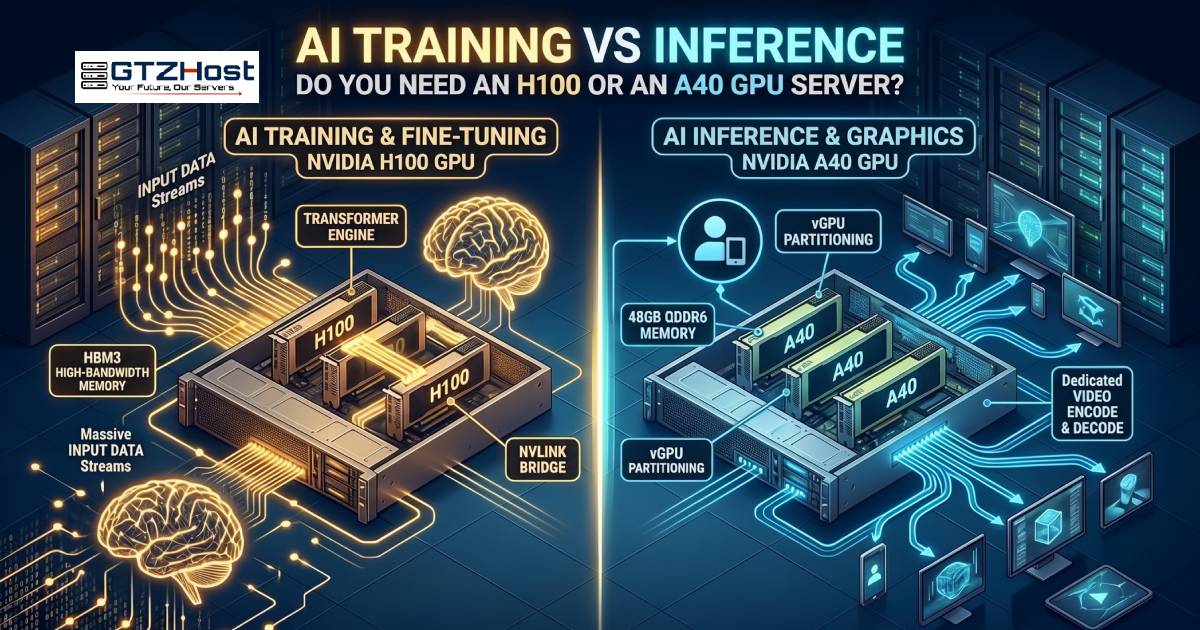
Architectural Trade-offs: Matching GPU Silicon to the AI Lifecycle
When provisioning infrastructure for Large Language Models (LLMs), assigning workloads to the correct GPU microarchitecture is critical for cost-efficiency. The decision largely dictates whether a tea
Responses
Markdown supported · ⌘↵ to post
No responses yet.