Feed
Discussion
I Built a Prefix-Cache-Aware LLM Gateway in Go — And Reduced TTFT by 90%
Most backend engineers treat LLM inference like standard microservices. You stand up an Nginx or AWS ALB round-robin load balancer, spin up multiple GPU workers running vLLM, Triton, or Ollama, and di
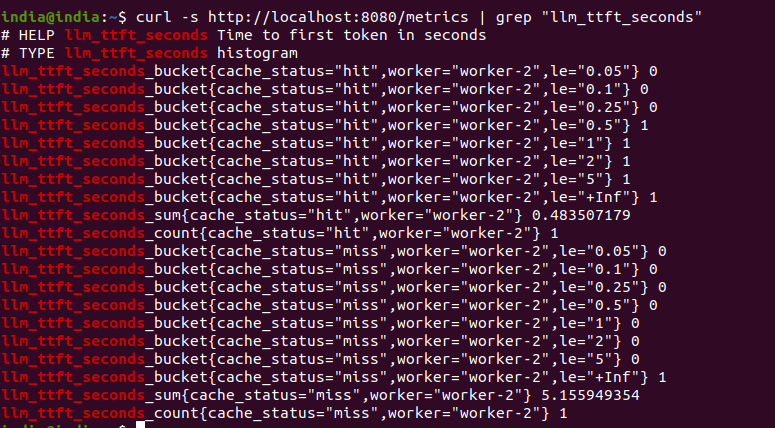
Responses
Markdown supported · ⌘↵ to post
No responses yet.