MemMachine: Ground-Truth Memory for AI Agents
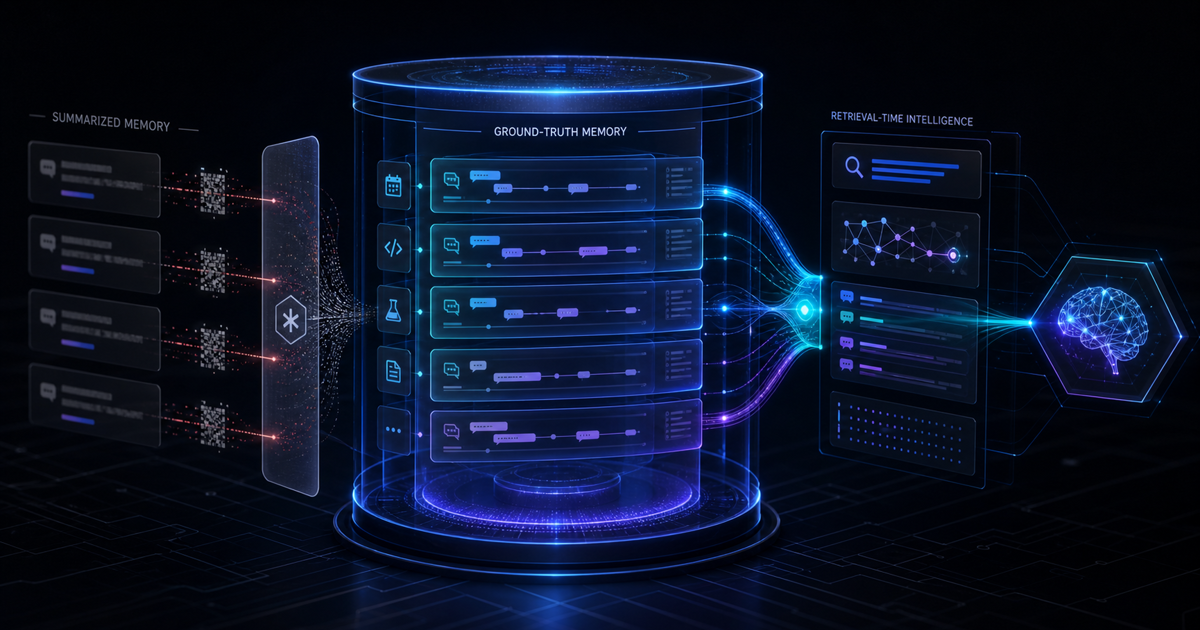
Every time an agent summarizes a conversation to save memory, it loses information. That trade-off has been accepted as unavoidable — LLMs produce long outputs, context windows are finite, and token costs are real. MemMachine, presented in arXiv pape...
Responses
Markdown supported · ⌘↵ to post
No responses yet.