Understanding the "Memory" of Large Language Models: What Exactly Is KV Cache?
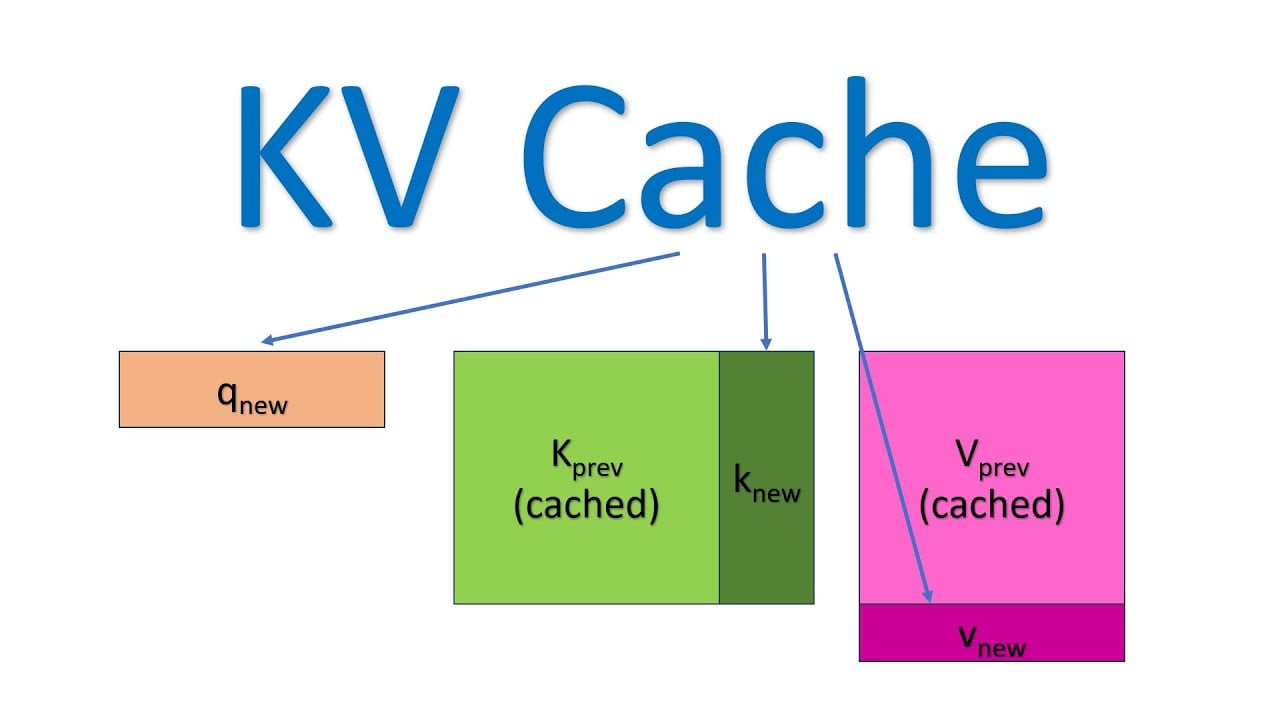
Abstract Autoregressive large language models generate output token by token. Without optimization, every newly predicted token forces the model to recompute attention projections for the entire prece
Responses
Markdown supported · ⌘↵ to post
No responses yet.