Optimizing GPU Resource Planning with NVIDIA Dynamo
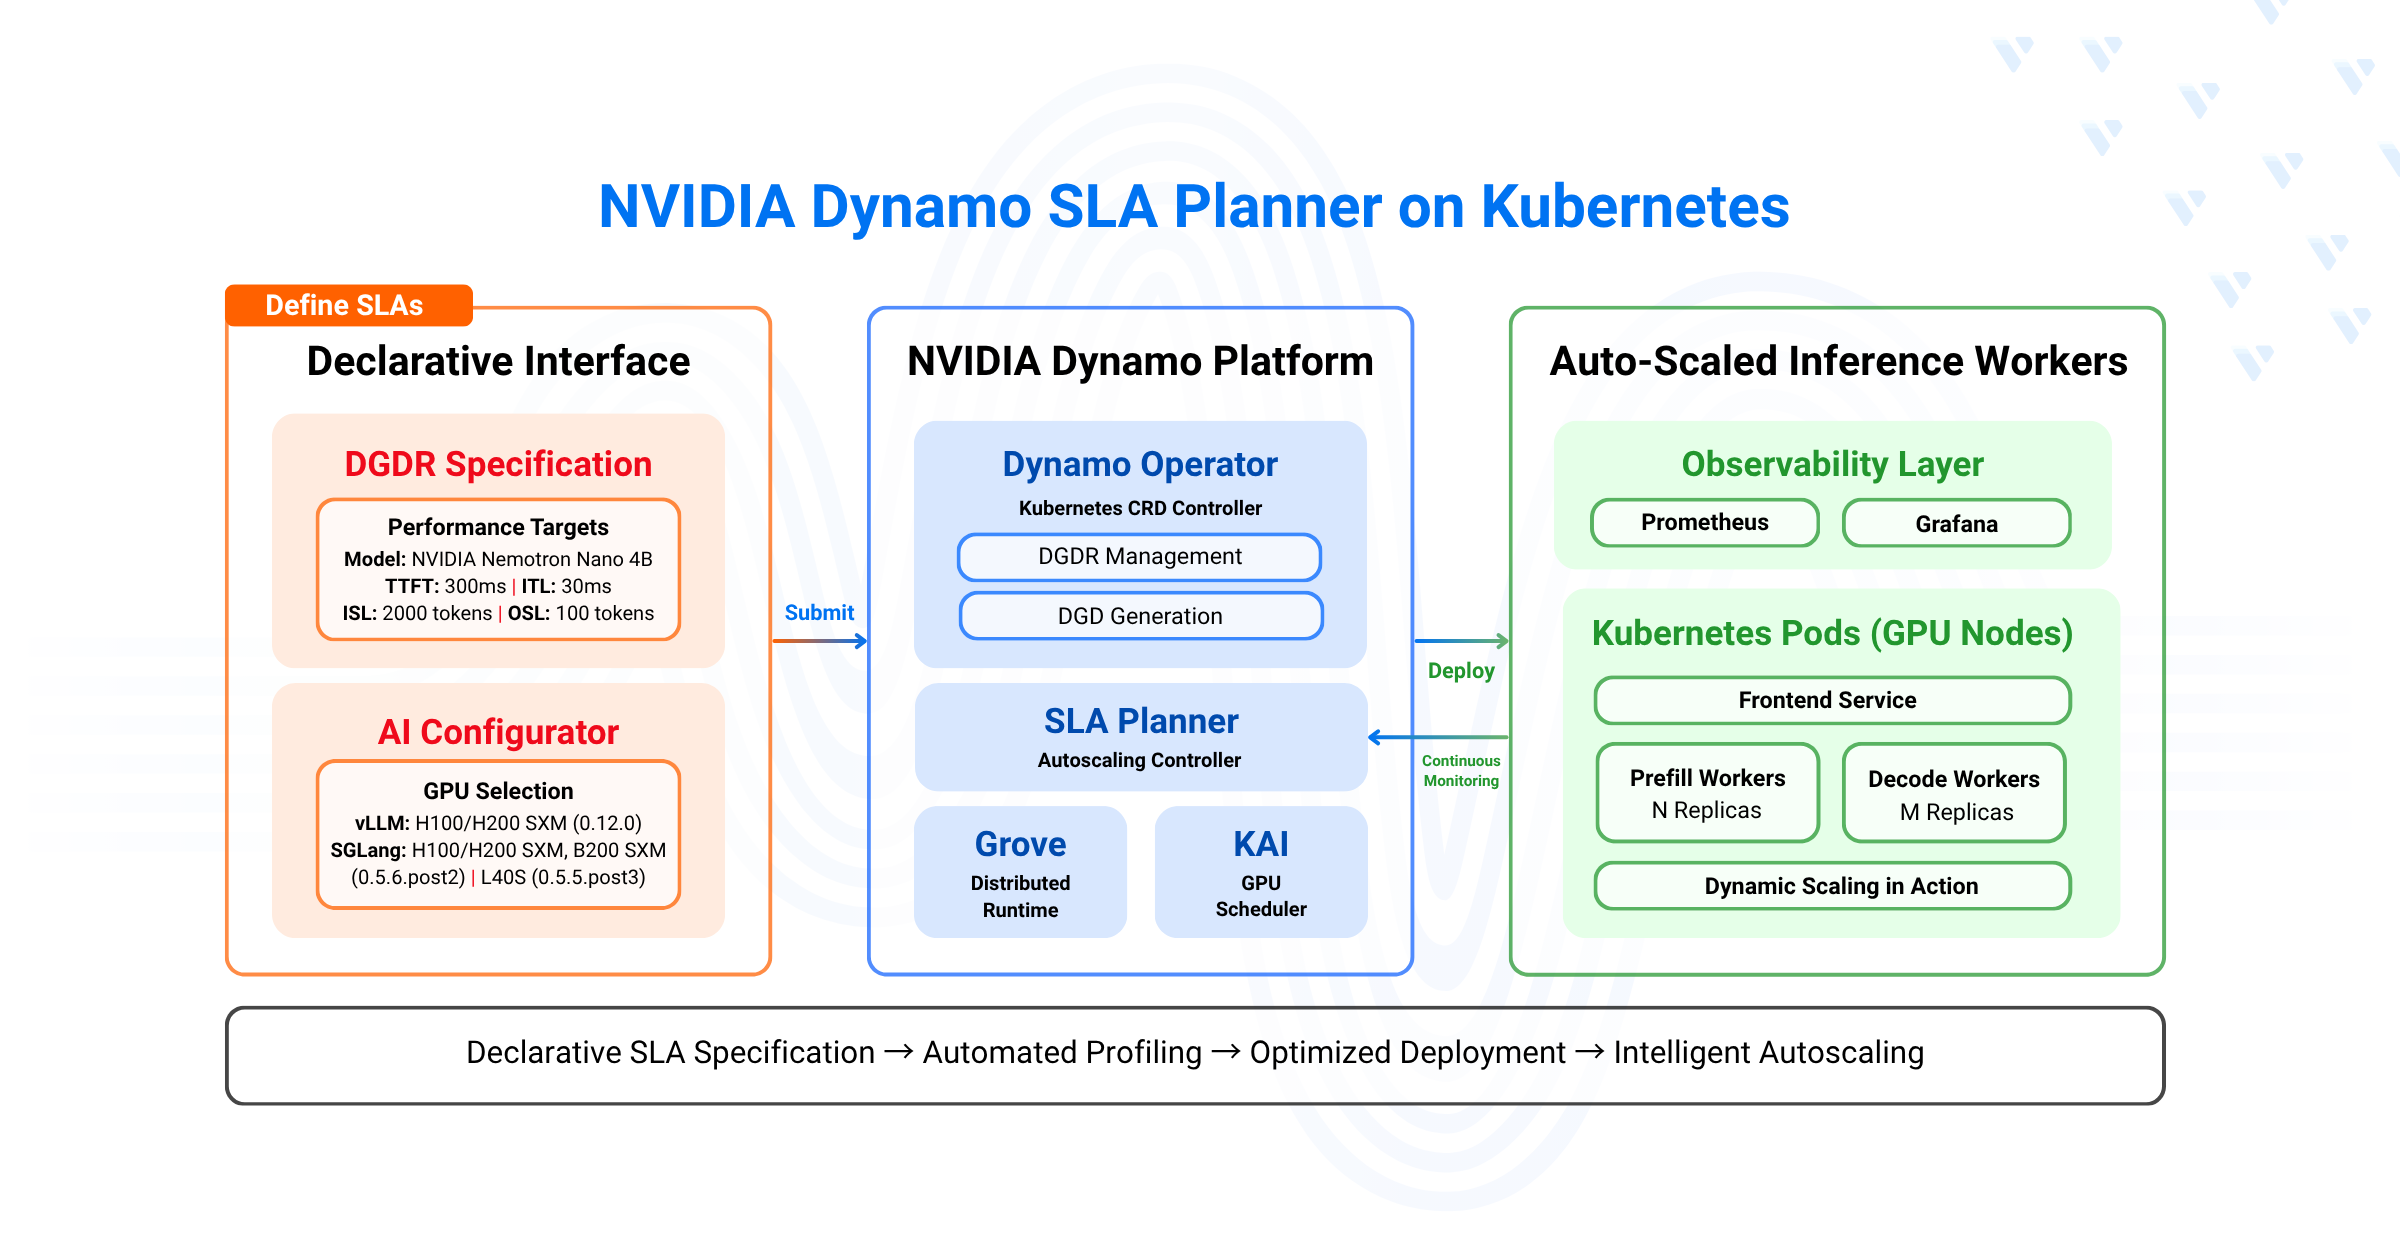
GPU resource allocation for LLM inference presents complex optimization challenges. Workloads exhibit variable request patterns, unpredictable sequence lengths, and strict latency requirements, making
Responses
Markdown supported · ⌘↵ to post
No responses yet.