从模型高分到可靠的个人 AI
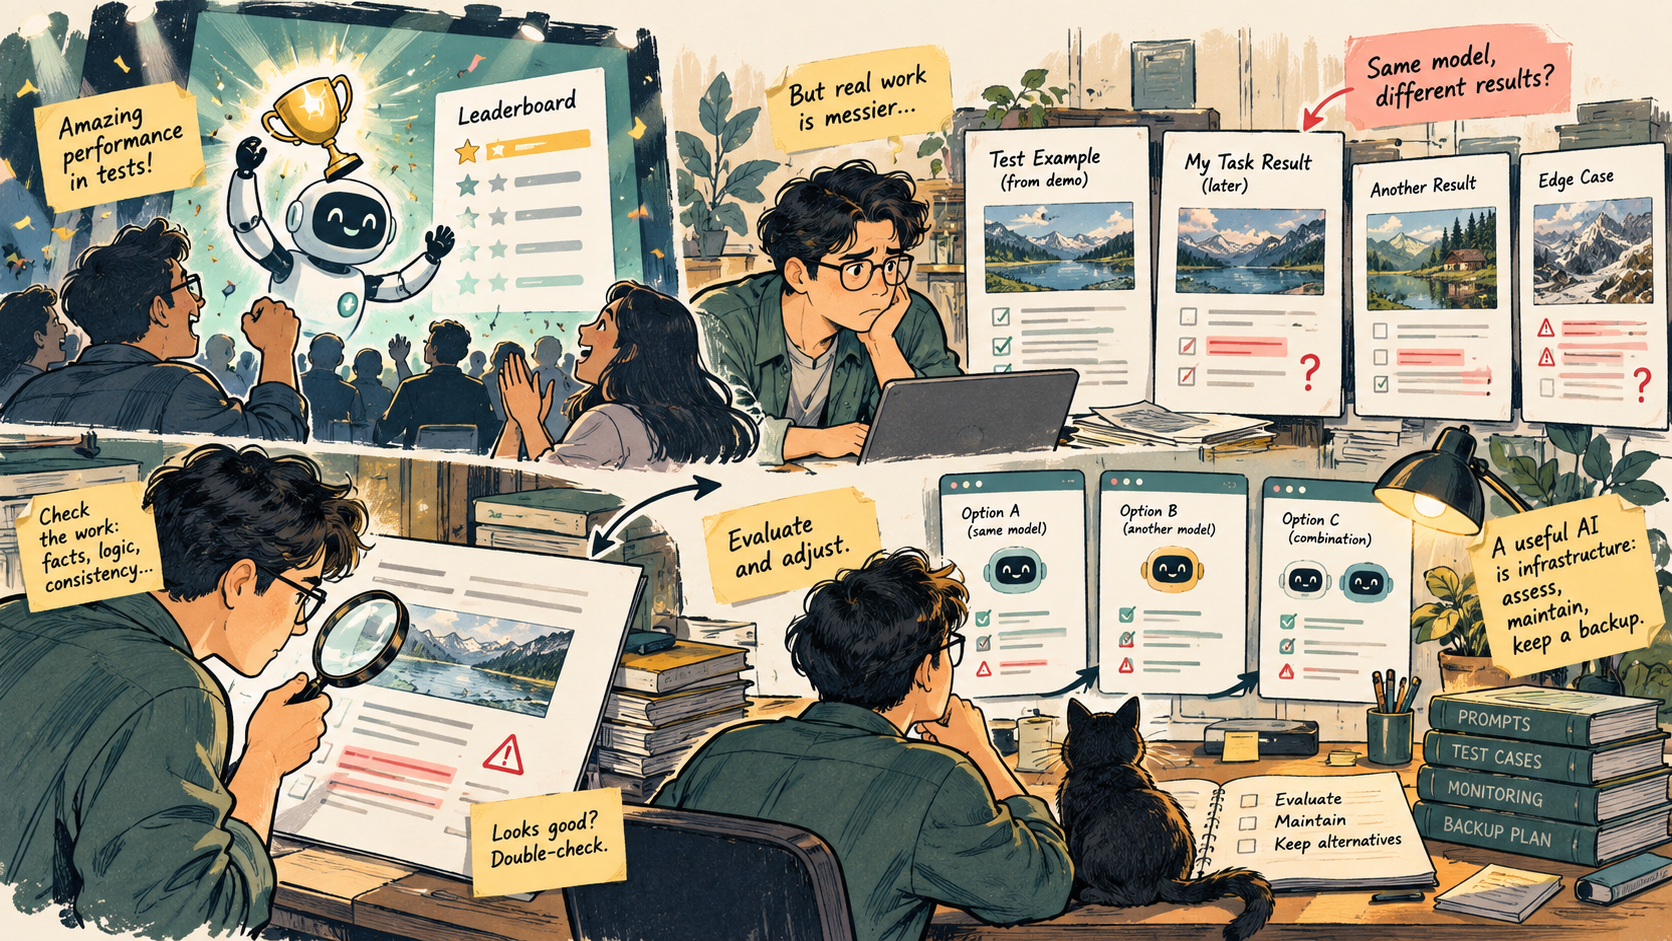
最近使用大语言模型时,我越来越在意一个问题:为什么发布时令人惊艳的模型,用上一段时间后,却未必还能给人同样可靠的感觉? 另一种让我在意的感受是“固执”:使用 GPT-6.1 Sol 时,我有时觉得它过于坚持自己的判断。我想知道,这只是我不适应它的交互风格,还是它接收纠正的方式确实存在问题。目前,这些仍是我的使用感受,还不是控制变量后的结论。 与此同时,模型发布时的高分又提出了另一种疑问:其中有多少
Responses
Markdown supported · ⌘↵ to post
No responses yet.